

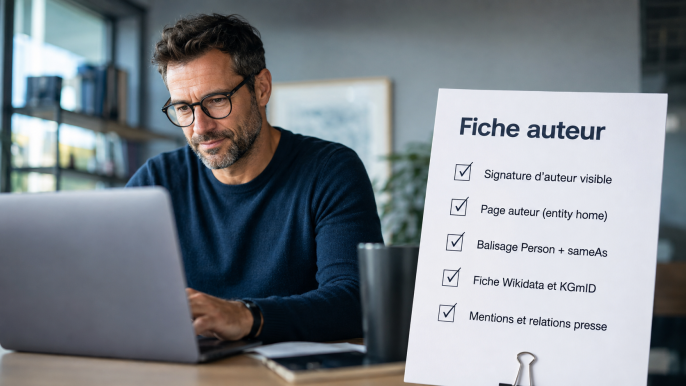
Le leak de Google, la documentation du Content Warehouse échappée en mai 2024, a réglé un vieux débat : le moteur enregistre les auteurs comme des entités, avec des attributs dédiés. Deux d’entre eux résument tout, et presque toutes les analyses les confondent. isAuthor est un booléen : Google sait, ou ne sait pas, qui vous êtes. authorReputationScore est un score gradué : ce que vous valez à ses yeux. Le premier se coche en un après-midi, le second se construit sur des années. Ce guide sépare les deux, montre comment vérifier où vous en êtes, et ce qui se travaille vraiment.
Ce que le leak a mis au jour sur les auteurs
La fuite, c’est environ 2 600 modules et plus de 14 000 attributs, décortiqués d’abord par Mike King (iPullRank) et Rand Fishkin. Deux entrées visent les auteurs. isAuthor figure dans un module qui décrit les entités d’un document, aux côtés d’isPublisher, de la connexité et d’un score de pertinence : Google y range qui a écrit, qui a publié, et à quel point l’entité est liée au reste du contenu. authorReputationScore, lui, loge dans un module baptisé WebrefMentionRatings, centré sur les mentions d’entités. Autrement dit, Google ne se contente pas d’indexer un texte : il le rattache à une personne, la vectorise, et garde en mémoire l’ensemble de ce qu’elle publie.
C’est un retournement d’histoire. Le vieux système d’authorship, le balisage rel=author relié au profil Google+, est mort en août 2014, et Google a répété qu’il ne servait pas au classement. L’affichage a disparu, mais la reconnaissance de l’auteur comme entité, elle, est revenue par la porte de derrière, cette fois dans la plomberie interne. Une réserve de méthode s’impose tout de suite : le leak expose des structures de données et des entrées, pas leur pondération. On sait que ces cases existent, on ignore leur poids réel et la façon exacte dont elles pèsent.
isAuthor : la reconnaissance, pas la récompense
isAuthor est une valeur binaire. Google sait qui a écrit la page, ou il l’ignore. C’est du tout ou rien, et c’est la partie facile de l’équation : une signature claire en tête d’article, une vraie page auteur, un balisage propre, et la case se coche. Rien qui réclame un budget ou trois mois d’efforts. C’est exactement le niveau d’autorité auteur que nous détaillons dans notre guide sur l’Author Rank : être identifiable est un préalable, pas un aboutissement.
Deux nuances que les résumés français passent sous silence. D’abord, en fouillant la documentation, plusieurs analystes constatent qu’isAuthor semble surtout calibré pour les contenus d’actualité, et que l’attribut isPublisher, l’éditeur du site, pèse vraisemblablement plus lourd que l’auteur individuel. Sur un blog lambda, la case cochée vaut donc moins que sur un média établi. Ensuite, un booléen ne classe rien à lui seul : il dit à Google « voici la personne », pas « cette personne fait autorité ». Prendre l’un pour l’autre, c’est confondre un laissez-passer avec une consécration.
authorReputationScore : le score qui se mérite
L’autre attribut joue dans une cour différente. Un score de réputation est gradué, et par construction il se bâtit hors de votre propre site : mentions, citations, historique de publications, corroboration par des sources tierces. Le module WebrefMentionRatings, où il se trouve, tourne justement autour des mentions d’entités. On retrouve la logique des proxies E-E-A-T mis au jour par le leak, comme l’effort de contenu ou l’originalité, sachant que Google a toujours martelé qu’il n’existe pas de « score E-E-A-T » unique. La réputation n’est pas une jauge qu’on pousse : c’est la résultante de dizaines de signaux réels.
Il ne faut pas davantage la confondre avec l’autorité du site. Le leak a confirmé un siteAuthority distinct, alimenté par le profil de liens et les mentions de marque, avec un attribut de promotion capable de peser sur le classement, celui que documente notre guide sur le Site Focus Score et l’autorité thématique. authorReputationScore concerne la personne, siteAuthority concerne le domaine. Et voici ce qui tranche : on fait basculer isAuthor avec du balisage, on ne fabrique pas une réputation. Les signaux montés de toutes pièces finissent escomptés, ce qui explique pourquoi payer pour des liens artificiels est un pari de plus en plus perdant.
Le tableau ci-dessous résume la mécanique. Les deux premières colonnes viennent de la documentation fuitée ; la dernière indique ce que vous pouvez réellement influencer, et à quel coût.
| Attribut | Nature | Ce qu’il mesure | Levier réel |
|---|---|---|---|
| isAuthor | Booléen (oui / non) | Google identifie l’auteur du contenu | Fort et rapide : signature, page auteur, balisage |
| authorReputationScore | Score gradué | La réputation de l’auteur, via ses mentions | Lent : corroboration réelle, sur la durée |
| siteAuthority | Score gradué | L’autorité du site, pas de l’auteur | Liens et mentions de marque |
Vérifier si Google vous reconnaît déjà comme entité
Avant de travailler quoi que ce soit, mesurez le point de départ. Si Google a créé une entité pour vous, elle porte un identifiant machine, le KGmID (le fameux code de type kg:/m/ que l’on retrouve dans le Knowledge Graph). Le posséder signifie que le moteur sait qui vous êtes ; ne pas en avoir, c’est être invisible à l’étage des entités. On interroge cet identifiant via l’API Knowledge Graph Search de Google, et un pont efficace passe par une fiche Wikidata, dont le QID (identifiant permanent) sert de référence que le moteur sait lire. Bonne nouvelle : créer un item Wikidata pour une organisation ou une personne légitime ne suppose aucun seuil de notoriété, et l’identifiant obtenu est permanent.
Pour aller vite, un outil comme le chercheur de KGmID de Cat’s Eye interroge directement l’API Knowledge Graph à partir de votre nom d’entité, de votre domaine ou d’un KGmID connu, et vous dit si Google vous a déjà indexé comme entité. C’est un diagnostic, pas un raccourci : il vous situe, il ne fabrique rien. Savoir que vous n’avez pas de KGmID est déjà une information qui oriente tout le reste du travail.
La méthode concrète, étape par étape
Première brique, gratuite : faites passer isAuthor à « oui » proprement. Cela tient à trois choses simples. Une signature visible en début d’article. Une page auteur qui sert de point d’ancrage à la personne, ce que le métier appelle l’entity home. Un balisage Person qui déclare l’identité et la relie au reste du web. Concrètement, ce balisage doit porter :
- le type Person, le nom et l’URL de la page auteur ;
- une propriété sameAs pointant vers vos profils réels et vérifiables : LinkedIn, Wikidata, éventuellement une fiche Muck Rack pour les journalistes ;
- un lien clair entre l’auteur et l’organisation pour laquelle il écrit.
Vous n’avez pas à l’écrire à la main : c’est typiquement ce que produit en quelques clics notre générateur de JSON-LD gratuit. Cette étape ne coûte rien et se règle en une après-midi.
Seconde brique, longue : nourrir la réputation. Publier avec régularité sur une thématique cohérente, puisque la concentration est récompensée et la dispersion pénalisée. Obtenir de vraies mentions et un peu de relations presse. Signer des articles invités sur des sites reconnus de votre domaine. Aucune de ces actions ne se raccourcit avec un empilement de comptes ou de fiches fabriquées. Et l’enjeu déborde le classement classique : les entités bien établies nourrissent désormais les réponses génératives, ce qui rejoint la question de qui dicte les réponses de l’IA. Une entité auteur reconnue, c’est multiplier ses chances d’être cité, pas seulement d’être classé.
Pourquoi l’entité doit être nette : le cas des deux Danny Goodwin
Un exemple vaut mieux qu’un long discours. Pendant des années, le Knowledge Graph a confondu deux personnes portant le nom de Danny Goodwin, envoyant la crédibilité de l’une vers l’autre. Il a fallu un travail d’entity SEO, mené par Jason Barnard, pour démêler les deux identités et rendre à chacune ce qui lui revenait. La leçon est directe : la réputation s’attache à une entité précise. Si votre entité est floue, dédoublée ou mal reliée, votre authorReputationScore, aussi mérité soit-il, peut bénéficier à quelqu’un d’autre, ou se diluer dans le vide. Cocher isAuthor ne suffit donc pas ; encore faut-il que l’entité désignée soit la bonne, et une seule.
Les limites, et le verdict
Trois garde-fous avant de conclure. La documentation ne livre aucune pondération : savoir qu’un attribut existe ne dit pas combien il pèse, ni dans quels contextes. isAuthor paraît plus déterminant pour l’actualité que pour un site ordinaire, donc l’effet varie selon votre terrain. Enfin, ces documents ont un âge, et Google fait évoluer ses systèmes en continu : une case présente en 2024 n’est pas une preuve d’usage aujourd’hui.
Reste l’essentiel, et il est simple. Travaillez votre entité auteur : c’est un actif réel que le leak a rendu tangible, et qui compte de plus en plus à l’heure des réponses générées. Mais ne prenez jamais la reconnaissance pour de l’autorité. isAuthor se coche en un après-midi ; authorReputationScore se construit sur des années de publications et de mentions réelles. Le premier vous fait exister aux yeux de Google. Le second, seul, vous fait compter.


