

Generative Assistenten haben in wenigen Monaten den Eindruck erweckt, jedermann einen Juristen, Übersetzer oder Entwickler auf Knopfdruck zur Verfügung zu stellen. Doch hinter dieser Leichtigkeit verbirgt sich eine sehr materielle Realität: energieintensive Server, seltene Metalle, Wasser zur Kühlung und vor allem ein immer teurer werdender Datenzugang. In diesem Kontext ist die Wahl einer offenen KI und einer lokalen künstlichen Intelligenz kein ideologischer Luxus: es ist eine Strategie für technologische Freiheit, gerechte Zugänglichkeit und digitale Souveränität.
Eine offene und lokale KI annehmen: warum das Rennen um Monopole seine Grenzen zeigt
Seit der Welle der Überraschung, die durch generative KI ausgelöst wurde, dachten viele, „größer“ bedeute automatisch „besser“. Doch ein altes wirtschaftliches Prinzip, das Gesetz der abnehmenden Erträge (im 18. Jahrhundert von Turgot formalisiert und später von Ricardo theoretisch begründet), trifft hier sehr gut zu: Die ersten massiven Investitionen brachten einen spektakulären Sprung, dann brachte jeder zusätzliche Milliarde subtilere Gewinne. Für den durchschnittlichen Nutzer wird der Unterschied im Alltag manchmal schwer wahrnehmbar.
Ein Signal hat sich eingeprägt: die eher verhaltene Aufnahme einer neuen Generation von Modellen für den Massenmarkt im Sommer 2025 popularisierte die Idee einer Stagnation. Tatsächlich lässt sich dieses „Abbremsen“ durch die Verknappung der Produktionsfaktoren erklären: Energie, elektronische Komponenten und Daten. Wenn diese Inputs knapp werden, wird die Abhängigkeit von einigen wenigen globalen Anbietern zur Schwachstelle und nicht nur zu einem politischen Thema.
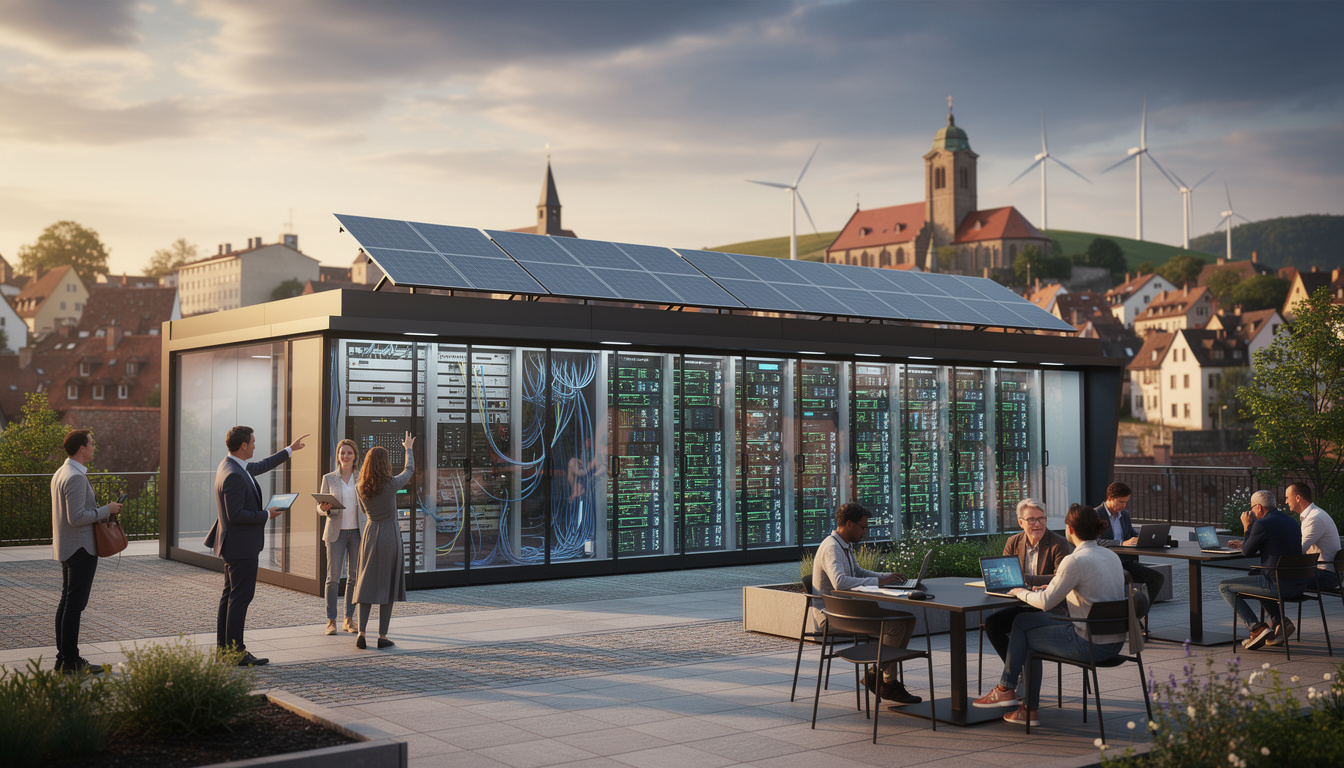
Von wahrgenommener Magie zu realer Infrastruktur: Energie, Wasser, Metalle und Daten
Was Sie auf dem Bildschirm sehen, ist leicht, doch was es möglich macht, ist schwer. Server-Farmen verbrauchen Strom, erfordern Kühlung (oft über große Wassermengen) und basieren auf bereits angespannten Lieferketten für Metalle und Komponenten. Mit steigenden Kosten verliert das Argument „wir outsourcen alles über eine API“ seine Einfachheit.
Der strukturbildendste Punkt bleibt jedoch die Daten. Die erste Phase der generativen KI profitierte von einem „Buffet“: drei Jahrzehnte Webinhalte (Foren, Enzyklopädien, soziale Netzwerke, frei zugängliche Artikel) wurden günstig zur Schulung verwendet. Heute ändert sich die Lage: mehr Einschränkungen, mehr Lizenzen, höhere Kosten und ein wachsender Anspruch an algorithmische Transparenz bezüglich der Herkunft der Korpora.
Wenn der Treibstoff (Daten und Energie) knapp und teuer wird, lautet die Frage nicht mehr „wer hat das größte Modell?“, sondern „wer kann mit Sparsamkeit und Kontrolle Wert schaffen?“. Genau hier liegen die Vorteile lokaler künstlicher Intelligenz und offener Zusammenarbeit.
Lokale künstliche Intelligenz: die Kontrolle zurückgewinnen ohne auf Leistung zu verzichten
Lokale künstliche Intelligenz bedeutet, Modelle so nah wie möglich an den Bedürfnissen auszuführen und anzupassen: in Ihrem Unternehmen, Ihrer Gemeinde, Ihrem Verein, manchmal sogar auf einem regionalen Server oder einer leistungsstarken Arbeitsstation. Das Ziel ist nicht, die Giganten zu kopieren, sondern verhältnismäßige Lösungen zu wählen, die besser auditierbar sind und besser an reale Rahmenbedingungen angepasst sind: Vertraulichkeit, Geschäftskontinuität, Budget, Regulierung.
Um dies anschaulich zu machen, folgen wir einem Leitfaden. In Lille nutzte „Atelier Nord“, ein Dienstleistungs-PKM mit 120 Mitarbeitenden, mehrere proprietäre APIs zum Zusammenfassen von Verträgen, zur Unterstützung des Kundensupports und zur Erstellung kommerzieller Antworten. Nach zwei Vorfällen (Preissteigerung und Änderung der Nutzungsbedingungen) stellte das Team auf eine offene KI um, die auf einer beherrschten Infrastruktur eingesetzt wird. Ergebnis: weniger Überraschungen, bessere Nachvollziehbarkeit und stabilere Nutzung für die Fachabteilungen.
Demokratisierung der KI: vom „Cloud-Standardwerkzeug“ zum kontrollierten Dienst
Die Demokratisierung der KI beschränkt sich nicht darauf, das Werkzeug mit einem Klick zugänglich zu machen. Sie setzt voraus, Abhängigkeiten zu verringern, Audits zu erleichtern und es mittelgroßen Organisationen zu ermöglichen, nachhaltige Anwendungen zu entwickeln. Eine offene KI unterstützt diese Bewegung, denn sie erlaubt Inspektion, Anpassung, Dokumentation und gemeinsame Nutzung.
In einer Gebietskörperschaft ist der Ansatz ähnlich, hat aber andere Prioritäten. Zum Beispiel kann ein Departement einen lokalen Assistenten bereitstellen, um Mitarbeitende bei der Suche nach Informationen in internen Leitfäden zu unterstützen und gleichzeitig zu verhindern, dass sensible Daten den Zuständigkeitsbereich verlassen. Der Nutzen ist zweifach: gerechter Zugang für alle Dienste (auch solche mit geringeren Budgets) und Verringerung des rechtlichen Risikos bei Datentransfers.
Dieser Weg führt natürlich zu einer Frage: Wie vergleicht man, ohne Schlagworte, die Optionen „fremdbetreute proprietäre API“ und „offene lokale KI“? Eine einfache Tabelle klärt die Abwägungen.
| Kriterium | Proprietäre API (gehostet von großem Anbieter) | Offene KI + lokale künstliche Intelligenz |
|---|---|---|
| Kosten | Variabel, empfindlich gegenüber Preissteigerungen und Kontingenten | Besser vorhersagbar: Infrastrukturinvestition + Nutzungsoptimierung |
| Digitale Souveränität | Starke Abhängigkeit von einem Anbieter und dessen Fahrplan | Erhöhte Kontrolle: Wahl des Modells, Hostings, Nutzungsregeln |
| Vertraulichkeit | Datenübertragung zu Dritten, Verträge und Einstellungen erforderlich | Daten lokal oder in vertrauenswürdigem Cloud-Speicher, vereinfachte Governance |
| Algorithmische Transparenz | Begrenzt: Trainingsdetails und Parameter meist nicht auditierbar | Bessere Auditierbarkeit (je nach Lizenzen, Dokumentation, Nachverfolgbarkeit der Datensätze) |
| Inklusive Innovation | Starker Zugang, aber ungleich je nach Mitteln und Verhandlungen | Möglichkeit zum Teilen zwischen lokalen Akteuren, gemeinsame Nutzung und gerechter Zugang |
| Resilienz | Risiko von Ausfällen: API-Änderungen, Bedingungen oder Zugang | Stärkere Kontinuität: Sie kontrollieren Versionen und Update-Zyklen |
Aus den Monopolen ausbrechen: technologische Freiheit, gerechter Zugang und inklusive Innovation
Monopole sind nicht nur ein Preisproblem. Sie konzentrieren Entscheidungen: welche Funktionen existieren, welche Sprachen Priorität haben, welche Kontrollmodalitäten möglich sind. Im Gegensatz dazu ermöglicht eine offene KI die Verteilung handlungsfähiger Kapazitäten: Sie können ein Modell an eine Fachsprache, eine regionale Sprache, eine Sicherheitsrichtlinie oder an einen öffentlichen Archivierungsrahmen anpassen.
Eine interessante Dynamik entsteht: technologische Gemeinschaften (Unternehmen, Labs, Verbände, öffentliche Bedienstete) entwickeln gemeinsam wiederverwendbare Bausteine. Diese offene Zusammenarbeit beschleunigt die Aneignung und reduziert Doppelarbeiten, besonders wenn Budgets begrenzt sind und die Bedürfnisse sehr konkret.
Algorithmische Transparenz: von „deklarativem“ zu „nachprüfbarem“ Vertrauen
Algorithmische Transparenz wird zu einem Qualitätskriterium, gleichrangig mit Genauigkeit. Wenn ein Assistent eine Empfehlung im HR-Bereich, eine rechtliche Zusammenfassung oder eine Hilfestellung bei der Wartungsdiagnose erzeugt, müssen Sie erklären können: aus welchen Quellen, mit welchen Regeln und mit welchen Grenzen. Ein lokaler Ansatz macht diese Kontrollen einfacher, da Ihre Logs, Filter und Schutzmaßnahmen in Ihrem Bereich bleiben.
Konkretes Beispiel: Eine Stadtverwaltung stellt einen Assistenten bereit, um Bürgerinnen und Bürger zu leiten. Statt eines „Blackbox“-Chatbots wählt sie ein offenes Modell, verbunden mit einer versionierten kommunalen Dokumentationsdatenbank. Jede Antwort ist auf eine offizielle Seite zurückverfolgbar, was Halluzinationen reduziert und den gleichberechtigten Zugang zu Informationen stärkt.
Eine offene KI umsetzen: praktische Schritte für Unternehmen, Gebietskörperschaften und Privatpersonen
Der Wechsel zu einer offenen KI erfolgt nicht über Nacht: Nutzung, Daten und Betrieb müssen definiert werden. Der klassische Fehler ist, mit dem Modell zu beginnen, während der Erfolg zuerst von den Geschäftsanforderungen und der Qualität der verfügbaren Informationen abhängt. Wenn dieses Fundament gelegt ist, wird die Wahl einer lokalen künstlichen Intelligenz zum Hebel der Kontrolle, nicht zur Einschränkung.
Operative Checkliste für eine sparsame und nachhaltige Einführung
Hier eine einfache Aktionsliste, die sowohl für ein KMU als auch für eine Gebietskörperschaft anwendbar ist, und auch für fortgeschrittene Privatpersonen (Selbstständige, reglementierte Berufe, Verbände) nützlich:
- Kartieren Sie drei prioritäre Anwendungsfälle (z. B. Support, Dokumentensuche, Textverfassung) mit messbarem erwarteten Nutzen.
- Klassifizieren Sie Ihre Daten nach Sensibilität (öffentlich, intern, vertraulich) und definieren Sie, was Ihren Bereich verlassen darf und was nicht.
- Testen Sie ein offenes Modell in einem begrenzten Bereich mit einer kontrollierten Dokumentationsbasis (offizielle Dokumente, Verfahren, interne FAQs).
- Implementieren Sie Schutzmaßnahmen: Quellenangaben, Ablehnung sensibler Inhalte, Protokollierung und menschliche Kontrolle der Entscheidungen.
- Organisieren Sie den Kompetenzaufbau: ein Tandem aus Fachseite und Technik, sowie eine Ansprechperson für „Antwortqualitätsmanagement“, um Gimmicks zu vermeiden.
- Planen Sie den Betrieb: Updates, Überwachung, Energiekosten und Regeln zur Protokollaufbewahrung.
Im Hintergrund steht die klare Herausforderung: technologische Freiheit bedeutet nicht „alles alleine machen“, sondern die Dinge wählen, die Sie kontrollieren und die Sie gemeinsam nutzen. Erst in der Kombination aus offener KI, lokaler künstlicher Intelligenz und offener Zusammenarbeit entsteht ein glaubwürdiger, sparsamer und wirklich auf inklusive Innovation ausgerichteter Weg.


